크롤링 뜻과 합법 기준, 파이썬 예제까지 — robots.txt 24곳 직접 확인
크롤링은 프로그램이 웹페이지를 돌며 정보를 자동으로 모으는 일이에요. 스크래핑·API 와의 차이, 대법원 2021도1533 판결문으로 본 합법 기준, 국내외 24곳 robots.txt 조사, 직접 돌린 파이썬 예제와 결과 0개가 나오는 이유, 403·429 대응, 코딩 없이 하는 방법과 비용까지 정리했어요.
목차 보기
크롤링은 프로그램이 웹페이지를 돌아다니며 정보를 자동으로 모으는 일이에요. 공개된 페이지를 사람처럼 천천히 읽는 건 대체로 괜찮아요. 하지만 로그인·차단을 넘거나, 개인정보를 모으거나, 남의 데이터베이스를 통째로 베끼면 문제가 돼요. 파이썬 예제를 직접 돌려 보고, 국내외 사이트 24곳의 robots.txt 를 하나씩 열어 확인했어요.
이 글은 크롤링 뜻, 스크래핑·API 와의 차이, 대법원 판결문으로 본 합법 기준, robots.txt 읽는 법, 최소 파이썬 예제와 실제 출력, 결과가 0개 나오는 이유, 막혔을 때 해도 되는 일, 코딩 없이 하는 방법과 비용까지 차례로 다뤄요. 숫자는 2026년 10월 27일 직접 돌린 값과 원문 자료로만 썼어요.
먼저 답부터
- 크롤링은 링크를 따라 페이지를 찾아다니는 것, 스크래핑은 페이지에서 필요한 칸만 뽑는 것이에요. 실제로는 둘을 섞어 써요.
- 대법원은 2022년 경쟁사 앱 서버에서 숙박 정보를 모은 사건에서 세 가지 죄를 모두 무죄로 확정했어요. 기준은 '보호조치·약관 등으로 접근을 막았느냐'였어요. 판결문에 robots.txt 는 나오지 않아요.
- 그래도 robots.txt 는 지키세요. 개인정보위 안내서도 약관·robots.txt 준수를 안전조치로 권해요. 24곳을 열어 보니 이름 없는 크롤러에게 하위 페이지를 허락한 곳은 17곳이었어요.
- 파이썬 코드 30줄 남짓으로 연습용 사이트 3쪽에서 책 60권을 모았어요. 자바스크립트로 그리는 페이지는 같은 코드로 0개가 나와요.
이 글을 쓰려고 직접 해 본 것(2026-10-27)
- 크롤링 연습용으로 공개된 사이트(books.toscrape.com, quotes.toscrape.com)에서 파이썬 예제를 돌리고, 출력과 처음 난 오류 2개를 그대로 옮겼어요.
- 국내외 사이트 24곳의 robots.txt 를 사이트마다 한 번씩, 1초 간격으로 받아 RFC 9309 규칙대로 판정했어요. 파이썬 기본 도구와 판정이 갈리는 곳도 찾았어요.
- 대법원 판결문 PDF(7쪽)를 열어 쟁점·판단 문장을 대조했고, 개인정보위 보도자료와 네이버·유튜브 API 공식 문서의 한도를 확인했어요.
- 개인정보가 담긴 페이지는 모으지 않았고, 돈이 드는 수집 서비스는 실행하지 않았어요.
읽기 전에 알아 둘 말 4개
- 크롤러(봇) — 웹을 자동으로 돌아다니는 프로그램이에요. 구글의 Googlebot, 네이버의 Yeti 가 대표적이에요.
- HTML — 웹페이지의 뼈대 글자예요. 크롤러는 이걸 받아 필요한 칸을 찾아요.
- robots.txt — 사이트 주인이 "로봇은 여기까지만 와 주세요"라고 적어 둔 파일이에요. 사이트 주소 뒤에 /robots.txt 를 붙이면 보여요.
- API — 회사가 "이 창구로 요청하면 정리된 데이터를 줄게요"라고 열어 둔 공식 통로예요.
크롤링은 무엇인가요?
crawl 은 영어로 '기어다니다'예요. 크롤러는 시작 주소에서 출발해 링크를 하나씩 따라가며 페이지를 모아요. 거미가 거미줄을 타는 모습 같다고 해서 스파이더라고도 불러요.
가장 큰 크롤러는 검색엔진이에요. 구글·네이버가 내 블로그 글을 검색 결과에 보여 줄 수 있는 것도 크롤러가 먼저 다녀갔기 때문이에요. 가격 비교 사이트, 뉴스 모음 앱, AI 학습 데이터도 크롤링으로 모아요. 회사에서는 경쟁사 가격 확인, 리뷰 모으기, 공고 모니터링에 많이 써요.
※ 다른 뜻으로 찾으셨다면 — 대출·홈택스·건강보험 앱에서 말하는 '스크래핑'은 내 아이디·인증서로 기관 사이트에 대신 접속해 내 정보를 가져오는 방식이에요(개인정보위 보도자료 정의, 2026-01-16). 그 앱의 "스크래핑 오류"는 해당 앱이나 기관에 문의하세요. 펍 크롤링(술집 순회)·크롤링 머신(운동기구)도 이 글과 다른 뜻이에요.
크롤링·스크래핑·API 는 뭐가 달라요?
한국어 글에서는 크롤링과 스크래핑을 섞어 써요. 엄밀히 나누면 아래와 같아요.
| 구분 | 크롤링 | 스크래핑 | API |
|---|---|---|---|
| 하는 일 | 링크를 따라 페이지를 찾아다녀요 | 페이지에서 필요한 칸(제목·가격)만 뽑아요 | 회사가 정리된 데이터를 공식 창구로 줘요 |
| 결과 | 페이지 주소 목록, HTML 원본 | 표(CSV·엑셀) | JSON 같은 정리된 데이터 |
| 사이트가 바뀌면 | 링크 구조가 바뀌면 멈춰요 | 화면 모양이 바뀌면 멈춰요 | 약속된 형식이라 잘 안 바뀌어요 |
| 허락 | 사이트 규칙(robots.txt·약관)을 봐야 해요 | 같아요 | 가입·키 발급으로 허락받아요 |
| 한도 | 정해진 게 없지만 너무 빠르면 막혀요 | 같아요 | 하루 몇 회처럼 정해져 있어요 |
API 가 있으면 API 먼저 보세요
공식 API 는 허락받은 길이라 법·차단 걱정이 적어요. 대신 한도가 있어요. 2026-10-27 공식 문서 기준이에요.
| API | 한도(2026-10-27 확인) | 알아 둘 점 |
|---|---|---|
| 네이버 검색 API(블로그) | 하루 25,000회 | 한 번에 최대 100건, 시작 위치 최대 1,000 → 검색어 하나로 약 1,100건까지 |
| 유튜브 Data API | 기본 할당 하루 1만 단위 | 검색(search.list)은 하루 100회로 따로 잡혀 있어요 |
한도는 회사가 바꿀 수 있으니 쓰기 전에 위 공식 문서에서 다시 확인하세요. API 로 안 되는 정보가 있을 때 크롤링을 생각하면 돼요. 이때부터는 아래 법·규칙을 꼭 봐야 해요.
크롤링, 불법인가요?
크롤링 자체를 금지하는 법은 없어요. 대신 크롤링하면서 하는 행동이 여러 법에 걸릴 수 있어요. 가장 많이 인용되는 판결부터 원문으로 볼게요.
대법원 2021도1533 판결문에는 뭐라고 적혀 있나요?
경쟁 숙박 앱 회사 쪽 피고인들이 상대 회사 앱이 쓰는 서버 주소를 알아내 프로그램으로 숙박업소 정보를 모은 사건이에요. 대법원은 2022년 5월 12일 검사의 상고를 기각해 무죄를 확정했어요(판결문 PDF).
| 쟁점 | 법 | 판단 | 판결문이 든 이유(요약) |
|---|---|---|---|
| 남의 정보통신망에 침입했나 | 정보통신망법 제48조 | 무죄 | 접근을 막았는지는 '보호조치나 이용약관 등 객관적으로 드러난 사정'으로 봐요. 서버 접근을 막는 보호조치가 없었고, 약관의 '영리 이용 금지'는 정보 이용을 막은 것이지 접근을 막은 게 아니에요 |
| 데이터베이스를 베꼈나 | 저작권법 제93조 | 무죄 | 모은 정보가 데이터베이스의 '상당한 부분'이 아니었어요. 양과 질, 만든 회사의 투자를 함께 봐요 |
| 서버에 장애를 일으켰나 | 형법 제314조 제2항 | 무죄 | 정보처리에 장애가 실제로 생겼다는 증거가 부족했어요 |
이 판결을 "크롤링은 다 합법"으로 읽으면 안 돼요. 거꾸로 보면 로그인·차단 같은 보호조치가 있거나, 데이터베이스의 상당 부분을 가져가거나, 서버에 실제 장애를 내면 판단이 달라질 수 있다는 뜻이에요. 또 이건 형사 재판이에요. 손해배상 같은 민사 책임은 따로 다퉈요.
robots.txt 를 어기면 불법인가요?
robots.txt 의 국제 표준(RFC 9309, 2022년 9월)은 이 규칙이 "접근 권한을 주는 수단이 아니다"라고 스스로 밝혀요. 위 판결문 7쪽 어디에도 robots.txt 는 나오지 않아요. 그래서 "robots.txt 만 어겨도 처벌"이라는 말은 판결문으로 확인되지 않아요.
그렇다고 무시해도 된다는 뜻은 아니에요. 개인정보보호위원회의 2024년 7월 「AI 개발·서비스를 위한 공개된 개인정보 처리 안내서」는 웹에서 데이터를 모을 때 사이트 약관과 robots.txt 를 지키라고 안전조치로 권해요. 사이트 주인의 뜻이 적힌 문서이니, 지키는 쪽이 분쟁을 피하는 길이에요.
그 밖에 걸릴 수 있는 법
| 무엇을 하면 | 관련 법 | 쉽게 말하면 |
|---|---|---|
| 이름·연락처·사진처럼 사람을 알아볼 수 있는 정보를 모으면 | 개인정보 보호법 | 공개된 정보라도 개인정보예요. 처리할 법적 근거가 필요해요 |
| 남이 공들여 쌓은 데이터를 부정한 수단으로 가져가 쓰면 | 부정경쟁방지법(데이터 부정사용, 2022년 4월 도입) | 접근 권한이 없는 사람이 부정하게 얻은 데이터를 쓰는 걸 막아요 |
| 글·사진을 그대로 내 사이트에 다시 올리면 | 저작권법 | 사실 정보(가격·주소)와 달리 글·사진 자체는 저작물이에요 |
| 서버가 버거울 만큼 요청을 퍼부으면 | 형법(업무방해)·정보통신망법 | 사이트가 느려지거나 멈추면 문제가 돼요 |
해도 되는 것과 하지 말 것
- 괜찮은 편 — 로그인 없이 누구나 보는 페이지를, robots.txt 와 약관을 확인하고, 사람처럼 천천히(초 단위 간격) 읽어 필요한 칸만 모으기
- 조심 — 모은 데이터를 팔거나 공개하기, 같은 사이트를 매일 대량으로 긁기, 경쟁사 데이터베이스를 꾸준히 복제하기
- 하지 말 것 — 로그인·캡차·차단을 피해 들어가기, 남의 계정 쓰기, 개인정보 모으기, 서버에 부담 주기
- 이 글은 일반 정보예요. 사업으로 할 거라면 변호사 검토를 받으세요.
robots.txt 는 어떻게 읽어요?
사이트 주소 뒤에 /robots.txt 를 붙이면 누구나 볼 수 있어요. 줄은 세 종류만 알면 돼요.
| 줄 | 뜻 | 예 |
|---|---|---|
| User-agent | 어느 로봇에게 하는 말인지. * 는 '모든 로봇' | User-agent: * |
| Disallow | 이 경로로 시작하는 곳은 오지 마세요 | Disallow: /admin/ |
| Allow | 막은 곳 중에서도 여기는 와도 돼요 | Allow: /$ ($ 는 '여기서 끝', 즉 첫 화면만) |
규칙이 겹치면 더 길게 들어맞는 줄이 이겨요. 예를 들어 네이버 첫 화면(www.naver.com)은 "모든 로봇: 전부 막음, 단 첫 화면(/$)만 허용"이라고 적어 두었어요.
국내외 사이트 24곳을 직접 열어 봤어요
2026-10-27 10시 44분, 사이트마다 robots.txt 를 한 번씩 받아 "하위 페이지 하나(/zzz/test-page)에 들어가도 되나"를 로봇 종류별로 판정했어요. 판정은 RFC 9309 규칙(가장 긴 규칙 우선, * 와 $ 지원)대로 했어요.
쿠팡·무신사는 robots.txt 요청 자체에 403(접근 거부)을 돌려줘 표에서 뺐어요. 판정은 그 시각의 파일 기준이라 바뀔 수 있어요.
표로 보기
| 사이트 | 이름 없는 크롤러 | Googlebot | Yeti | ClaudeBot | GPTBot |
|---|---|---|---|---|---|
| 네이버 첫 화면 | X | X | X | X | X |
| 네이버 뉴스 | X | X | X | X | X |
| 네이버 블로그 | O | O | X | X | X |
| 다음 | X | X | X | X | X |
| 11번가 | X | O | O | X | X |
| G마켓 | O | O | O | X | X |
| 예스24 | O | O | O | O | O |
| 교보문고 | O | O | O | O | O |
| 다나와 | O | O | O | O | O |
| 나무위키 | X | X | X | X | X |
| 인벤 | O | O | O | O | O |
| 디시인사이드 | O | O | O | X | X |
| 뽐뿌 | O | O | O | O | O |
| 클리앙 | O | O | O | O | X |
| 대한민국 정책브리핑 | O | O | O | O | O |
| 공공데이터포털 | O | O | O | O | O |
| 연합뉴스 | O | O | O | X | X |
| 조선일보 | O | O | O | O | X |
| 중앙일보 | O | O | O | X | X |
| 유튜브 | O | O | O | O | O |
| 인스타그램 | X | O | X | X | X |
| X(트위터) | X | O | X | X | X |
| 위키백과(대문) | O | O | O | O | O |
| 한국어 위키백과 | O | O | O | O | O |
눈에 띈 점은 세 가지예요.
- 포털·위키는 거의 다 막았어요 — 네이버 첫 화면·네이버 뉴스·다음·나무위키는 이름 없는 크롤러뿐 아니라 구글도 하위 페이지에는 못 들어가게 적었어요.
- AI 봇은 이름을 찍어 막는 추세예요 — 24곳 중 13곳이 AI 회사 봇 이름을 직접 적었어요. 네이버 블로그·G마켓·디시인사이드·연합뉴스·중앙일보는 일반 크롤러는 받으면서 GPTBot 은 막았어요. 네이버 뉴스·블로그 파일에는 AI 학습·검색 증강용 봇 접근을 금지한다는 주석까지 있어요.
- 네이버 블로그는 네이버 자기 봇(Yeti)도 막아 두었어요 — robots.txt 맨 위에 User-agent: Yeti, Disallow: / 가 있어요.
파이썬 기본 도구는 결과가 달라요
파이썬에 들어 있는 urllib.robotparser 로 같은 파일을 읽으면 네이버 첫 화면도 "막힘"으로 나와요. 소스를 열어 보니 규칙을 위에서부터 읽어 처음 맞는 줄을 쓰고, $ 와 * 를 글자 그대로 비교해요(Python 3.12.8). 그래서 "Allow: /$" 를 알아보지 못해요. 규칙이 복잡한 사이트라면 RFC 9309 를 구현한 Protego(Scrapy 가 쓰는 파서) 같은 도구로 다시 확인하세요.
파이썬으로 직접 해 보기
연습은 크롤링 연습용으로 만든 공개 사이트에서 하세요. books.toscrape.com 은 가짜 책 1,000권을 올려 둔 연습장이에요. 준비물은 파이썬과 라이브러리 두 개예요.
pip install requests beautifulsoup4아래 코드는 robots.txt 를 먼저 확인하고, 2초씩 쉬면서 3쪽만 읽어 제목·가격·재고를 CSV 로 저장해요.
# 크롤링 연습용 사이트(books.toscrape.com)에서 책 제목·가격 모으기 — 3쪽, 요청 사이 2초
import csv, time, requests
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser
from bs4 import BeautifulSoup

START = "https://books.toscrape.com/catalogue/page-1.html"
UA = {"User-Agent": "my-study-crawler/0.1 (+mailto:me@example.com)"}

robots = RobotFileParser("https://books.toscrape.com/robots.txt")
robots.read()                                   # 404 면 '전부 허용'으로 읽어요

rows, url = [], START
for page in range(3):                           # 연습이니까 3쪽만
    if not robots.can_fetch(UA["User-Agent"], url):
        print("robots.txt 가 막은 주소:", url); break
    t0 = time.time()
    r = requests.get(url, headers=UA, timeout=10)
    r.raise_for_status()
    r.encoding = "utf-8"
    soup = BeautifulSoup(r.text, "html.parser")
    for book in soup.select("article.product_pod"):
        rows.append({
            "제목": book.h3.a["title"],
            "가격": book.select_one(".price_color").text,
            "재고": book.select_one(".availability").text.strip(),
        })
    print(f"{page+1}쪽 {r.status_code} {len(r.content):,}바이트 {time.time()-t0:.2f}초 누적 {len(rows)}권")
    nxt = soup.select_one("li.next a")
    if not nxt: break
    url = urljoin(url, nxt["href"])
    time.sleep(2)                               # 사이트에 무리 주지 않게

with open("books.csv", "w", newline="", encoding="utf-8-sig") as f:   # utf-8-sig = 엑셀에서 한글 안 깨짐
    w = csv.DictWriter(f, fieldnames=rows[0].keys()); w.writeheader(); w.writerows(rows)
print("저장:", len(rows), "권 → books.csv")
실제로 돌린 결과예요(2026-10-27, 서울 사무실 회선).
1쪽 200 50,469바이트 0.97초 누적 20권
2쪽 200 50,877바이트 1.09초 누적 40권
3쪽 200 51,374바이트 1.11초 누적 60권
저장: 60 권 → books.csv

# books.csv 앞부분
제목,가격,재고
A Light in the Attic,£51.77,In stock
Tipping the Velvet,£53.74,In stock
Soumission,£50.10,In stock
쪽마다 약 50KB, 1초 안팎이 걸렸어요. 2초씩 쉬었으니 3쪽에 약 9초예요. 1,000권 전부라면 50쪽이라 2분 30초쯤 걸려요. 서두를 이유가 없어요.
처음 돌릴 때 실제로 난 오류 2개
| 증상 | 원인 | 고친 방법 |
|---|---|---|
| UnicodeEncodeError: 'latin-1' codec can't encode characters | User-Agent(내 프로그램 이름표)에 한글 '연락처'를 넣었어요. HTTP 머리글은 영문만 돼요 | 이름표를 영문으로(my-study-crawler/0.1 (+mailto:…)) |
| 가격이 £51.77 이 아니라 £51.77 로 나와요 | 서버가 글자 인코딩을 안 알려 줘 requests 가 ISO-8859-1 로 짐작했어요 | r.encoding = "utf-8" 한 줄 추가 |
엑셀에서 한글이 깨질 때는 저장할 때 encoding="utf-8-sig" 로 쓰면 돼요. 위 코드에 이미 들어 있어요.
코드는 도는데 결과가 0개예요
가장 흔한 이유는 자바스크립트로 그리는 페이지예요. 브라우저는 HTML 을 받은 뒤 자바스크립트를 실행해 내용을 채워요. requests 는 자바스크립트를 실행하지 않으니 빈 뼈대만 받아요. 같은 인용구 10개를 두 방식으로 보여 주는 연습 사이트로 확인했어요.
requests 로 받은 /js/ 는 HTML 5,808바이트에 인용구 0개, 크롬으로 연 뒤 HTML 은 8,987바이트에 10개였어요. 크롬은 2.4초 걸렸어요.
표로 보기
| 받는 방법 | 받은 HTML | 인용구 | 걸린 시간 |
|---|---|---|---|
| requests · / | 11,064바이트 | 10개 | 1초 안쪽 |
| requests · /js/ | 5,808바이트 | 0개 | 1초 안쪽 |
| 크롬 헤드리스 · /js/ | 8,987바이트 | 10개 | 2.4초 |
해결은 두 가지예요. 하나는 브라우저를 프로그램으로 움직이는 도구(Playwright·Selenium)로 페이지를 연 뒤 읽는 거예요. 느리고 컴퓨터를 더 써요. 다른 하나는 브라우저 개발자 도구(F12)의 네트워크 탭에서 페이지가 몰래 불러오는 데이터 주소를 찾아 그걸 읽는 거예요. 다만 그 주소가 공개용인지, 약관이 허락하는지 먼저 확인하세요.
※ 크롬 헤드리스는 주소창 없이 뒤에서 도는 크롬이에요. 이 실험은 chrome --headless=new --dump-dom 주소 한 줄로 했어요.
403·429 로 막혔어요
사이트가 "그만"이라고 말하는 신호예요. 신호마다 해도 되는 대응이 달라요.
| 신호 | 뜻 | 해도 되는 대응 |
|---|---|---|
| 403 Forbidden | 이 요청은 받지 않겠다 | 멈추고 robots.txt·약관을 다시 보세요. 공식 API 나 제휴를 알아보세요 |
| 429 Too Many Requests | 너무 자주 왔다(RFC 6585) | 응답의 Retry-After 만큼 기다리고, 간격을 늘리세요 |
| 갑자기 빈 페이지·캡차 | 자동 프로그램으로 보고 막았다 | 멈추세요. 캡차는 '사람만 오라'는 뜻이에요 |
| IP 차단 | 이 주소에서 오는 요청을 막았다 | 속도를 줄이고 사이트에 문의하세요 |
"User-Agent 를 바꿔라", "프록시로 IP 를 돌려라" 같은 차단 피하기 요령도 검색하면 나와요. 하지만 사이트가 일부러 막은 걸 피해 들어가면, 위 판결이 말한 '보호조치로 막은 접근'을 넘는 쪽으로 기울어요. 막혔다면 멈추는 게 가장 안전해요.
코딩 없이 할 수는 없나요? 비용은요?
방법은 크게 다섯 가지예요. 2026-10-27 공개 가격 기준이에요.
| 방법 | 코딩 | 비용 | 이런 분께 |
|---|---|---|---|
| 내 PC 에서 파이썬 | 필요 | 0원(PC 를 켜 둬야 해요) | 연습, 한 번만 모을 때 |
| 서버에 올려 매일 자동 | 필요 | 퓨쳐인프라 가장 작은 서버(Nano) 월 9,000원 | 매일 정해진 시각에 돌릴 때 |
| 공식 API | 조금 | 무료 한도가 많아요(네이버 하루 25,000회) | API 가 있는 서비스 |
| 준비된 수집 프로그램(액터) | 없음 | 퓨쳐인프라 1,000건당 1,500~5,000원, 0건이면 0원 | 네이버·유튜브·쇼핑몰을 바로 모을 때 |
| 해외 수집 장터(Apify 등) | 없음 | 달러 결제, 액터마다 값이 달라요 | 해외 사이트가 많을 때 — Apify 가격 글 |
퓨쳐인프라 스크래핑은 이렇게 써요
퓨쳐인프라 스크래핑에는 바로 돌릴 수 있는 수집 프로그램(액터)이 99개 있어요. 네이버 25개, 유튜브 7개, SNS 16개, 커뮤니티 25개, 쇼핑몰 15개, 구글 3개, 웹·범용 8개예요(준비된 액터 목록). 콘솔에서 카드를 골라 입력 칸을 채우고 실행하면 결과를 표로 보고 CSV·엑셀로 받아요.
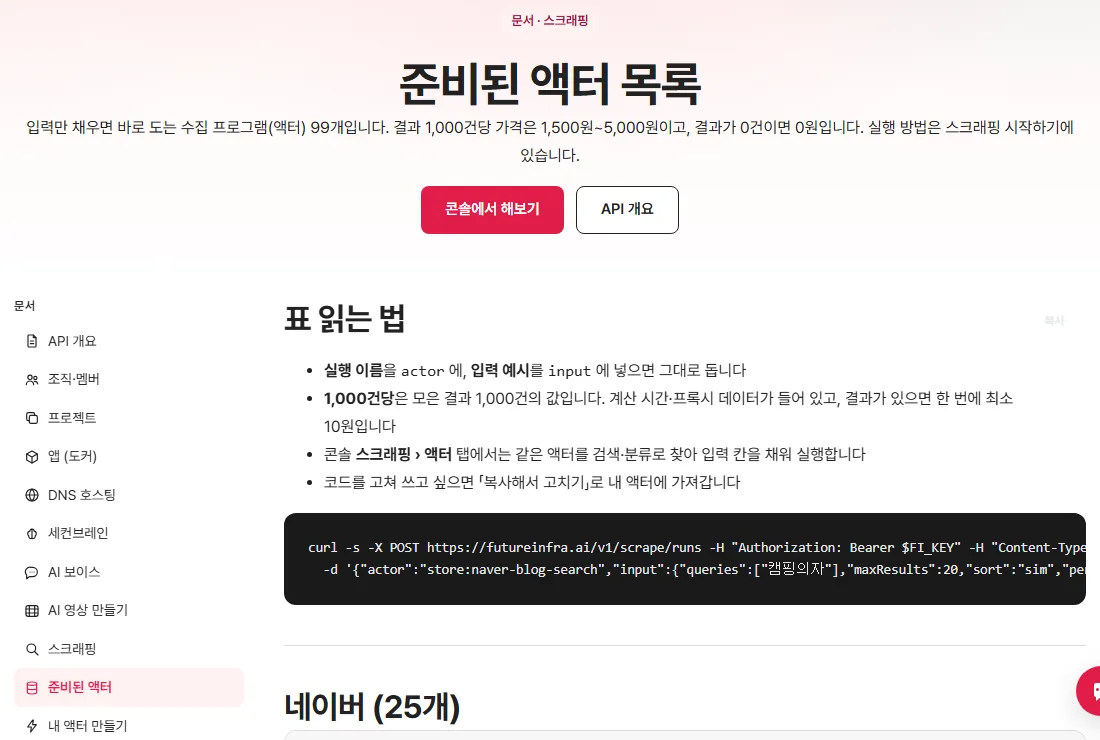
| 항목 | 공개 문서 값 |
|---|---|
| 준비된 액터 | 모은 결과 1,000건당 1,500원~5,000원(계산 시간·프록시 데이터 포함). 결과가 0건이면 0원, 있으면 한 번에 최소 10원 |
| 기본 수집기 | 아무 공개 페이지 주소를 넣어 읽기 — 페이지 1개당 1원, 브라우저로 읽으면 3원 |
| 결과 | JSON·CSV·엑셀, 30일 보관 |
| 운영 규칙 | 공개된 정보만 모으고, 글쓴이·댓글 작성자 같은 개인 정보는 결과에 넣지 않아요. 요청 사이에 간격을 둬요 |
| AI 에게 말로 시키기 | MCP 로 클로드 같은 AI 에 연결하면 "네이버 블로그에서 캠핑의자 글 20개 모아서 CSV로 줘"처럼 시킬 수 있어요 |
셈해 보면, 네이버 블로그 검색(1,000건당 1,500원)으로 200건을 모으면 300원이에요. 매일 1,000건씩 한 달이면 약 4만 5천 원이에요. 기본 수집기로 공개 페이지 300쪽을 매일 읽으면 한 달 9,000원이에요(스크래핑 시작하기, 요금).
이럴 땐 이렇게
| 이런 상황이면 | 이렇게 하세요 |
|---|---|
| 크롤링을 처음 배워요 | 연습용 사이트(toscrape)에서 requests + BeautifulSoup 부터. 실제 사이트는 robots.txt·약관 확인 뒤에 |
| 네이버·유튜브 데이터가 필요해요 | 공식 API 한도부터 보세요. 모자라면 준비된 액터를 쓰세요 |
| 결과가 0개예요 | 자바스크립트 페이지인지 확인하고, 브라우저 도구(Playwright)로 열어 보세요 |
| 403·429 가 떠요 | 멈추고 간격을 늘리세요. 차단을 피해 들어가지 마세요 |
| 모은 데이터를 서비스에 올리려 해요 | 개인정보·저작권·데이터베이스권을 검토하고, 사업이라면 변호사와 상의하세요 |
자주 묻는 질문
크롤링을 배우려면 어떤 언어가 좋아요?
파이썬이 가장 쉬워요. requests 로 페이지를 받고 BeautifulSoup 으로 칸을 찾는 두 가지만 알면 위 예제처럼 30줄 남짓으로 시작할 수 있어요.
네이버 블로그도 크롤링해도 돼요?
네이버 블로그 robots.txt 는 일반 크롤러에게 일부 경로만 막고, GPTBot 같은 AI 봇과 네이버 자체 봇 Yeti 는 막아 두었어요. 글 목록이 필요하면 하루 25,000회까지 쓰는 네이버 검색 API 를 먼저 쓰세요. 글 본문을 그대로 다시 올리는 건 저작권 문제가 돼요.
크롤링한 데이터를 팔거나 공개해도 되나요?
가격·주소 같은 사실 정보는 비교적 덜 위험하지만, 남의 데이터베이스 상당 부분을 꾸준히 가져가 팔면 데이터베이스권·부정경쟁 문제가 될 수 있어요. 글·사진은 저작물이에요. 사업이라면 법률 검토를 받으세요.
클로드나 ChatGPT 에게 크롤링을 시켜도 되나요?
돼요. MCP 로 수집 도구를 연결하면 말로 시킬 수 있어요. 다만 AI 가 대신 해도 robots.txt·약관·개인정보 규칙은 똑같이 적용돼요.
대출 앱의 '스크래핑 오류'도 이 글과 관련 있나요?
아니요. 그건 내 아이디·인증서로 기관 사이트에서 내 정보를 가져오는 방식이에요. 오류는 그 앱이나 기관(홈택스·건강보험공단 등)에 문의하세요.
같은 결과를 다시 확인하려면
- 환경 — 윈도우 11 25H2, Python 3.12.8, requests 2.34.2, beautifulsoup4 4.15.0, 크롬 헤드리스. 서울 사무실 유선 회선, 2026-10-27 오전.
- 예제 — 위 코드를 그대로 저장해 실행하면 돼요. 연습 사이트라 결과(책 60권)는 같고, 걸린 시간은 회선에 따라 달라요.
- robots.txt 조사 — 사이트마다 /robots.txt 를 한 번 받아(User-Agent 에 연구 목적과 블로그 주소 표기), 그룹 고르기·가장 긴 규칙 우선·*·$ 지원 규칙으로 판정했어요. 하위 경로는 /zzz/test-page 하나로 봤어요.
- 한계 — 경로 하나로만 판정해 사이트마다 허용 범위의 세부는 달라요. 약관은 따로 확인하지 않았어요.
이 글의 숫자 출처
- 대법원 2022. 5. 12. 선고 2021도1533 판결(PDF)
- RFC 9309 — Robots Exclusion Protocol(2022-09) · RFC 6585 — 429
- 개인정보위 보도자료(2026-01-16, 스크래핑 정의) · 개인정보위 「AI 개발·서비스를 위한 공개된 개인정보 처리 안내서」(2024-07-17)
- 네이버 검색 API 문서 · YouTube Data API 시작하기
- Protego(RFC 9309 파서) · 연습 사이트 books.toscrape.com · quotes.toscrape.com
- robots.txt 24곳 — 각 사이트 /robots.txt 원문(2026-10-27 10:44 수집)
- 퓨쳐인프라 스크래핑 문서 · 준비된 액터 목록 · 요금(2026-10-27 확인)
- 작성: 서순명(솔리드그루 이사 · 퓨쳐인프라 — 국내 IDC 에서 클라우드 서버·앱 호스팅·AI API 를 운영) · 작성일 2026-10-27
- 운영사: 솔리드그루 · 사업자등록번호 875-44-00335 · 서울특별시 구로구 디지털로29길 38, 7층 707호 · 전화 02-6933-6229 · support@futureinfra.ai · 고객센터 · 이용약관
- 한계: 예제는 연습용 공개 사이트에서만 돌렸고, 실제 쇼핑몰·포털 페이지는 수집하지 않았어요. robots.txt 판정은 그 시각 파일과 하위 경로 하나 기준이에요. 법 관련 내용은 판결문·공식 문서를 요약한 일반 정보이고 법률 자문이 아니에요. 개인정보위 안내서 원문 PDF 는 직접 열지 못해 보도·법무법인 해설로 확인했어요.
- 이해관계: 퓨쳐인프라는 스크래핑 서비스를 운영해요. 그래서 합법 기준은 우리 주장 대신 판결문·표준 문서로만 썼어요. 이 글의 행동 버튼은 퓨쳐인프라 문서로 연결돼요.
댓글 0
로그인하면 댓글을 남길 수 있습니다.